前段时间入职节子,快速过了一下 Go,顺便整理出了一篇博客,适合有一定语言基础,想快速建立全局观、快速入门 go的读者。本文首发于我的博客(推荐,获得更好的阅读体验) ps:这是一篇长文,时间紧张的读者可以直接跳转感兴趣的部分阅读,或者作为教程查阅
go的设计哲学是“少即是多”(Less is More),它刻意移除了许多 Java 中常见的特性(如类继承、复杂的异常体系等),以换取更简单的代码结构和更高的编译/运行效率极简的部署方式: 可直接编译成机器码不依赖其他第三方库直接运行即可部署
静态性语言 编译的时候能检查出隐藏的大多数问题
支持语言层面的并发 原生支持:原生的语法就支持并发
package main import ( "fmt" "time" ) func goFunc(i int){ fmt.Println("goroutine", i, "...") } func main(){ for i := 0;i<10000; i++ { go goFunc(i)// 开启一个并发协程 } time.Sleep(time.Second) } 不需要绑定 CPU,不需要配置线程池的一堆参数(核心线程数、非核心线程数……) 充分利用多核 CPU
强大的标准库 runtime 系统调度机制高效的 GC 垃圾回收
1.8 之后引入三色标记、混合写屏障 丰富的标准库: 文本操作、输入输出、时间日期、网络通信、统计值、数学…… 一般来说原生的标准库就能满足开发需求,除非有特殊需求 需要一些在某些性能/特点上更突出的第三方库
简单易学 25 个关键字C 语言简洁基因,内嵌 C 语法支持面向对象跨平台
各语言编译、运行耗时粗略对比: 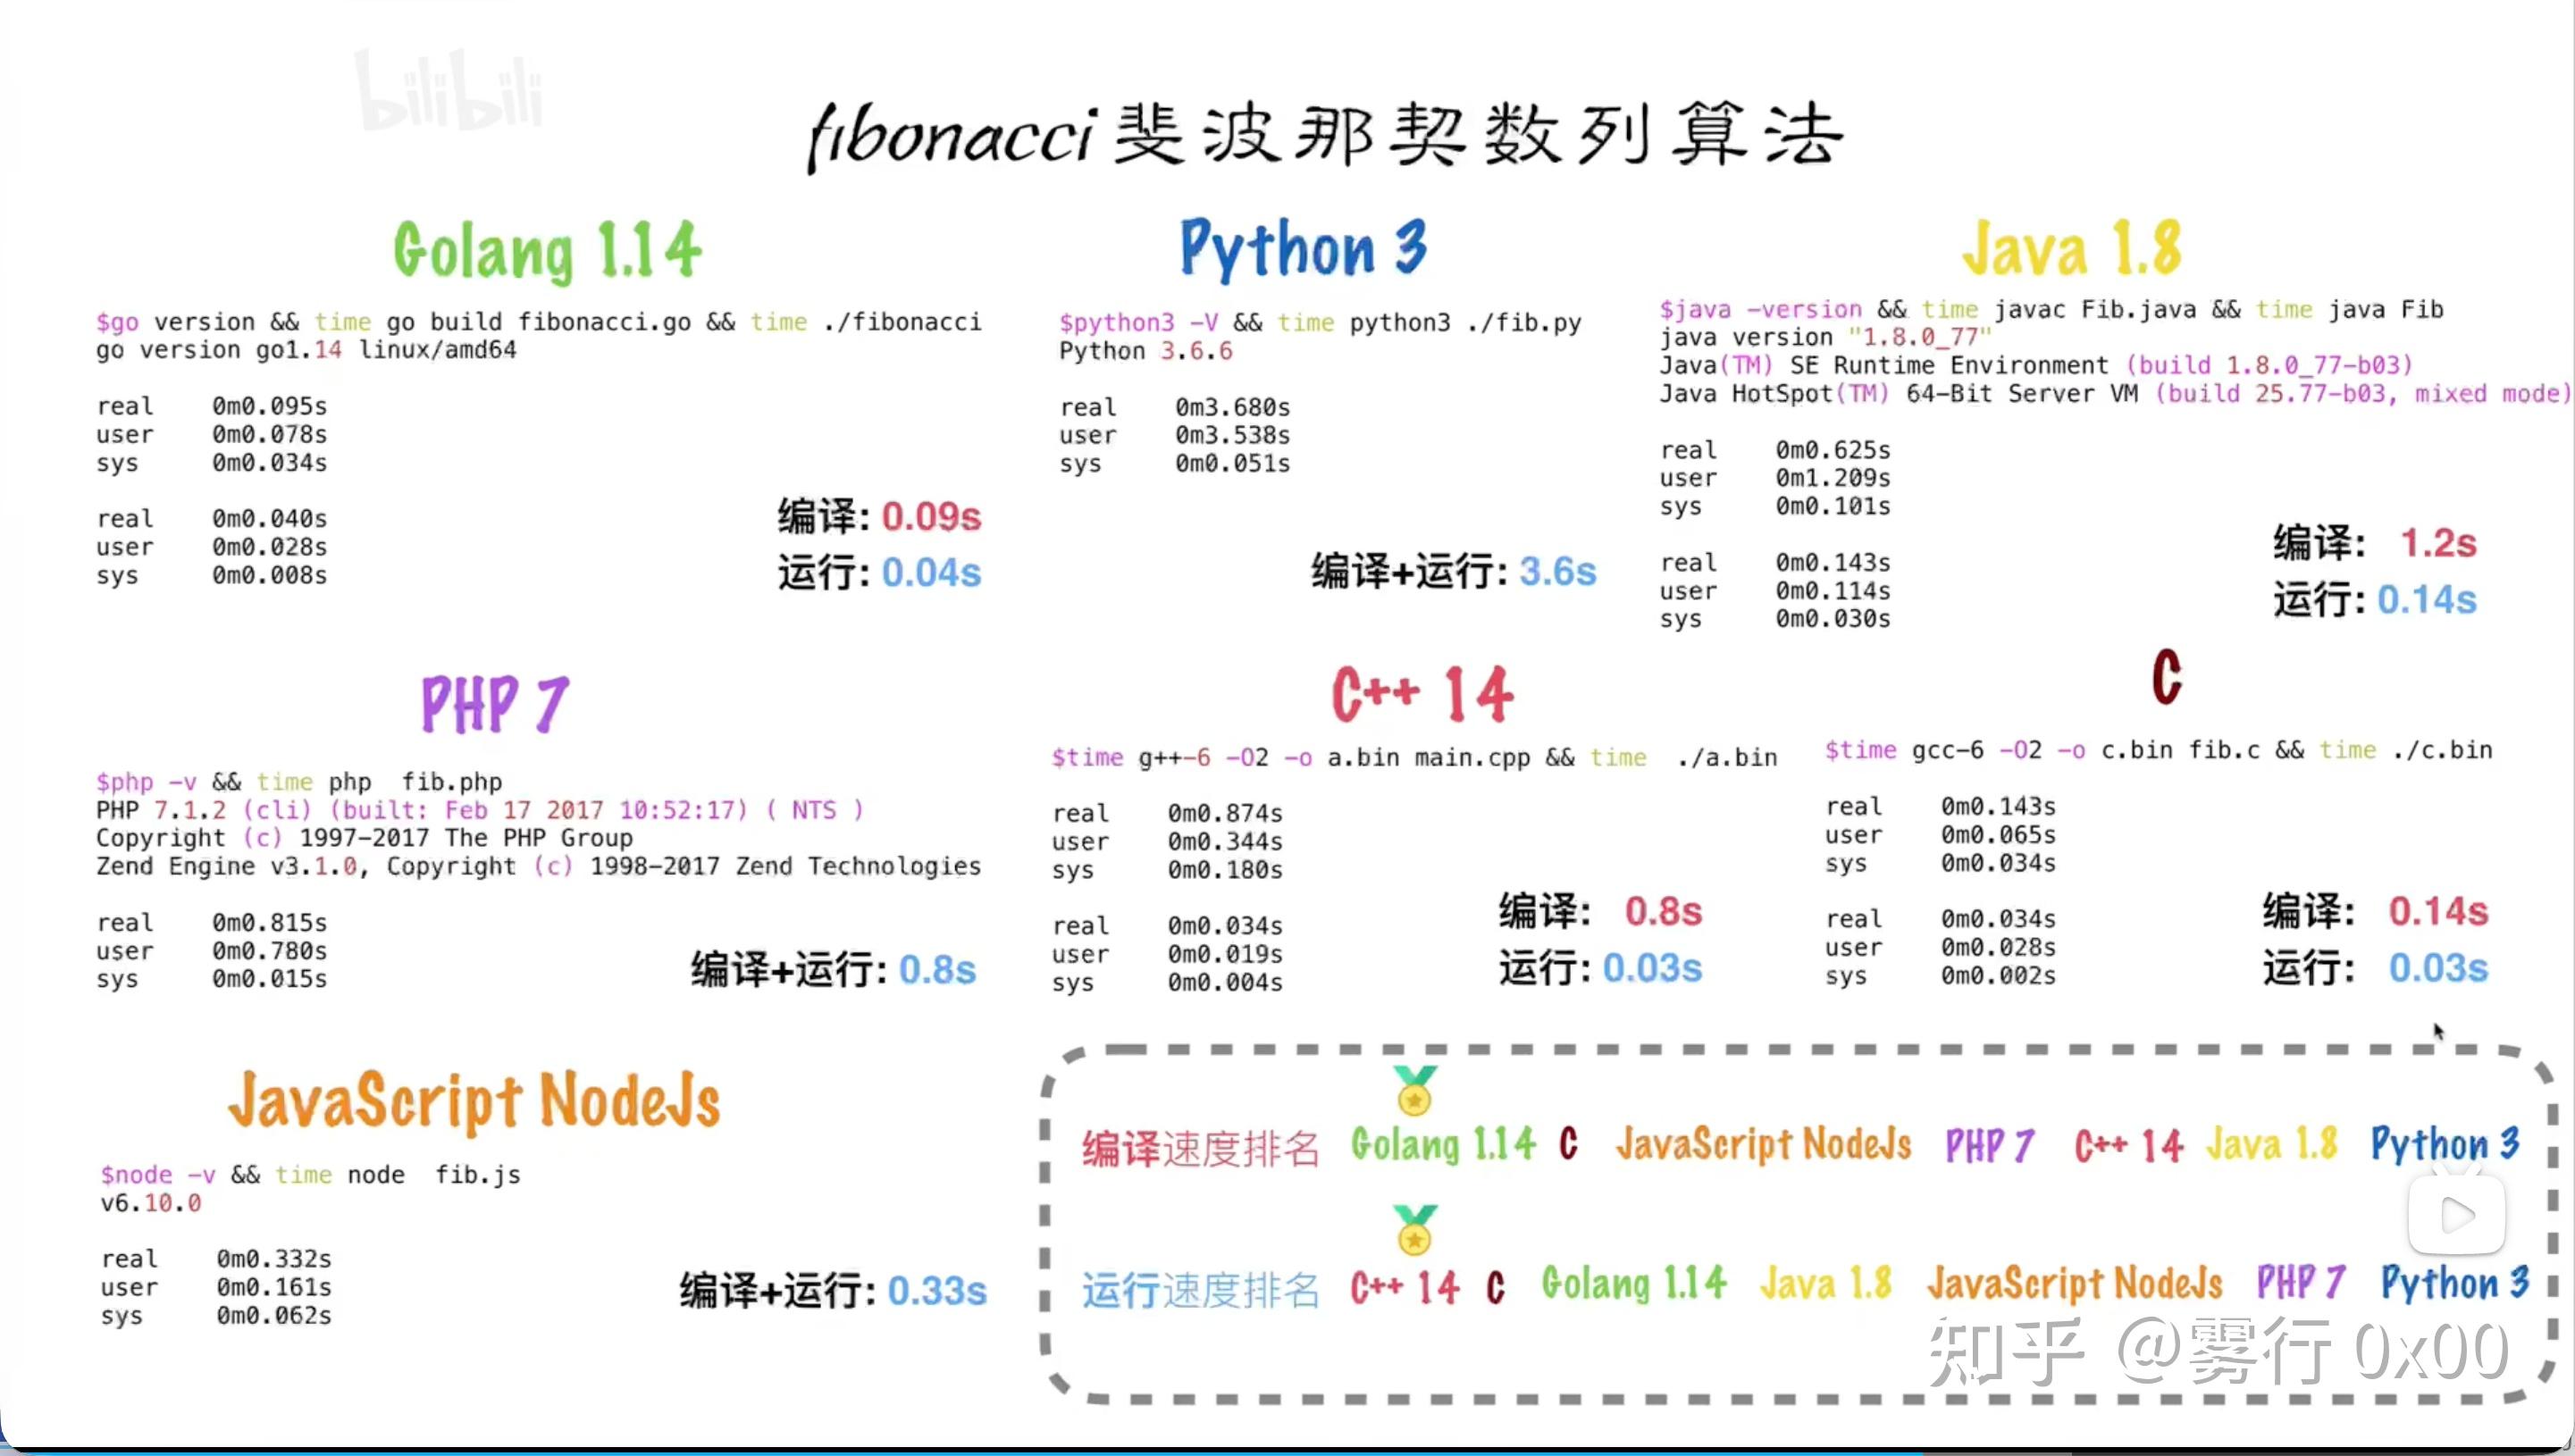
云计算基础设施领域 代表项目:docker、kubernetes、etcd、cloudflare CDN……基础后端软件 代表项目:tidb、influxdb、cockroachdb……微服务 代表项目:go-kit、micro、monzo back的 typhon、bilibili……互联网基础设施 代表项目:以太坊、hyperledger 等Go 大部分包都在 github 上,相对不太安全所有异常都用 Error 来处理:没有语法 (比较有争议)对 C 的降级处理并非无缝(不像 C++一样完美兼容)平台:https://go.dev/dl/ 或 https://goframe.org/docs/install-go/index检查是否安装成功
几个环境变量: GOROOT:源码包的安装路径GOPATH:当前用户的工作路径(写代码的地方),go install 安装的工具在 GOPATH/bin/(使用模块化管理则不需要配这个环境变量)
菜鸟工具GoLand(JetBrains出品,功能强大)Visual Studio Code + Go插件Vim/Neovim + LSP支持命令功能go run main.go直接运行Go源码go build main.go编译生成可执行文件main.go 编译完生成 main 文件;直接./main就能执行go fmt格式化代码go mod init初始化模块go test ./…运行所有测试go get http://github.com/user/repo下载第三方依赖
go 语言句末不需要分号强制的代码风格要求:左大括号 和函数名一定是在同一行,否则编译报错? 为什么 必须和函数名在同一行? Go 的词法器会在扫描源码时自动插入分号。规则是:如果换行前的最后一个 token 是标识符、数字/字符串字面量、或 之一,词法器会在其后自动插入分号。(这个规则同样适用于 、、) 所以如果写: > func main() > { // ← 词法器在 ) 后插入分号 → func main(); { ... 编译错误! > ``` > 所以 `{` 必须紧跟在函数签名后面。Go 代码中分号只出现在 `for` 循环子句等少数场景。 ### 1. 变量与常量 ```go // 声明变量的几种方式 // 1. 全写 var name string = "Alice" var age int = 30 var isActive bool // 2. 直接初始化 自动识别类型 var name = "Alice" // 3. 使用`:=`(常用) name := "Alice" age := 30 // 多变量声明 // 1. 标注类型 var c, python ,java bool // type 放多个变量的末尾 var x, y int = 1, 2 // 2. 直接初始化 自动识别类型 var rust, golang, javascript = true, false, "no!" // If an initializer is present, the type can be omitted(省略); the variable will take the type of the initializer. // 3. 使用 := 与 , 的形式 a, b := 10, 20 // 4. 块式批量声明 var ( ToBe bool = false MaxInt uint64 = 1<<64 - 1 z complex128 = cmplx.Sqrt(-5 + 12i) ) // 常量(只读) // 1. 标注类型 const PI float64 = 3.14159 // 2. 直接初始化 自动识别类型 const PI = 3.14159 // 3. 块式批量声明 const ( STATUSOK = 200 STATUSNOTFOUND = 404 ) // iota 常量生成器(Go 特有) const ( SONDAY = iota // 0 MONDAY // 1 TUESDAY // 2 )
? 注意事项: 只能在函数内部使用,全局变量必须用 关键字声明自动化类型推断: 当在声明变量时未显式指定类型(无论是 语法,还是使用 表达式语法),变量的类型都会根据右侧的值自动推断。 当声明右侧的值本身带有类型时,新变量就会具有相同的类型: > var i int > j := i // j is an int > ``` > > 当右侧包含一个无类型的数字常量时,新变量的类型会根据该常量的精度被推断为 `int`、`float64` 或 `complex128` > > ```go > i := 42 // int > f := 3.142 // float64 > g := 0.867 + 0.5i // complex128 > ``` - 声明的变量必须使用,否则编译报错 - **`:=` 的重新赋值规则**:`:=` 声明中,只要**至少有一个新变量**,已存在的变量可以被**重新赋值**(而非重新声明),前提是在**同一作用域**: ```go f, err := os.Open(name) // 声明 f 和 err d, err := f.Stat() // d 是新变量,err 只是重新赋值 ✅ // 注意:如果 err 在外部作用域已声明,这里会创建一个新的同名局部变量(shadowing)⚠️ 这个特性让长链的错误处理变得简洁:不需要为每次调用声明 ,可以一直复用 。常量在编译时确定,不能是函数返回值;常量的定义不能使用 语法
数组的长度是类型的一部分,不能重新调整 “declares a variable arr as an array of three integers.An array’s length is part of its type, so arrays cannot be resized.”入参是数组 的函数,使用的是值传递
切片,就是动态数组,相当于 Java/Python 里面的 List切片的定义:A slice literal is like an array literal without the length.
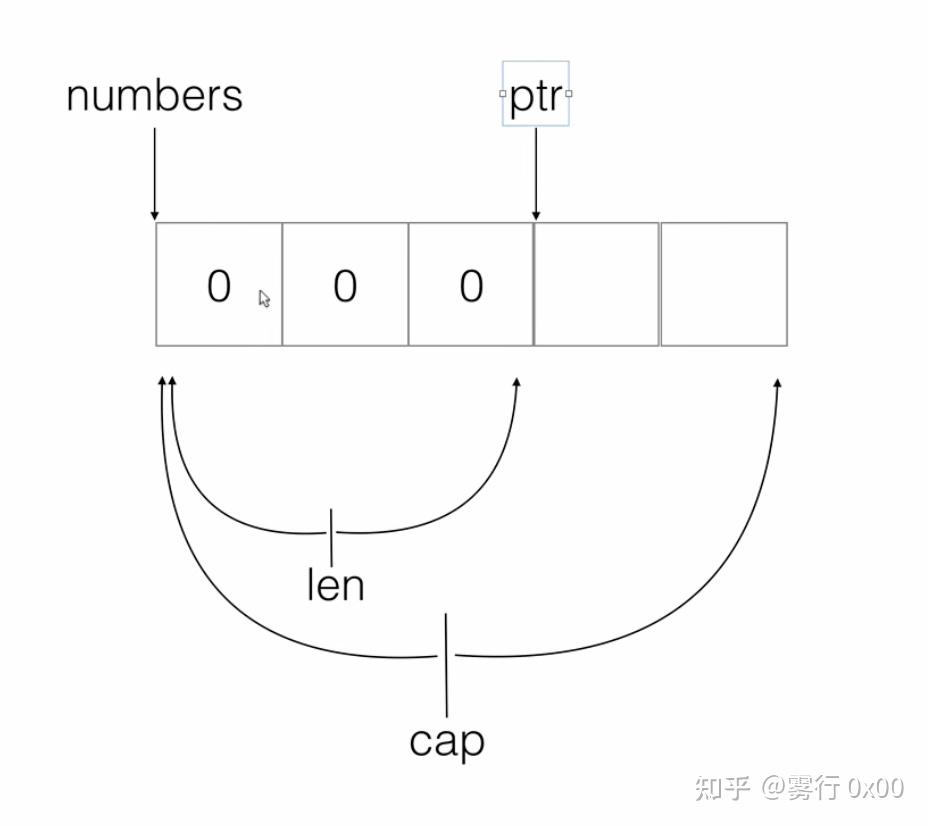
Go 语言的切片不是一个简单数组,是结构体,组成如下:指向底层数组的指针 :这个指针指向切片所引用的底层数组的起始位置 “A slice does not store any data, it just describes a section of an underlying array. Changing the elements of a slice modifies the corresponding elements of its underlying array. Other slices that share the same underlying array will see those changes.” package main import "fmt" func printArray(myArray []int) { // _ 表示匿名的变量 for _, value := range myArray { fmt.Println("value =", value) } // 传递方式:实际上这里传递的传值方式仍然是按值传递,类型是切片,形参接受到的是一个切片副本,切片内部维护了指向底层数组的指针、切片长度、容量,【所以形参和原变量指向的都是同一个底层数组,所以更改myArray[0] 原切片myArray[0]也会改变】 myArray[0] = 100 } func main() { myArray := []int{1, 2, 3, 4} // 动态数组,切片 slice printArray(myArray) fmt.Println(" === ") for _, value := range myArray { fmt.Println("value =", value) } } // 输出: // value = 1 // value = 2 // value = 3 // value = 4 // value = 100 // value = 2 // value = 3 // value = 4 长度 :切片中当前元素的数量容量:从切片起点到其底层数组末尾的元素数量。
切片的长度与容量:
切片(slice)同时具有长度(length)和容量(capacity)。 切片的长度是它所包含的元素个数。 切片的容量是其底层数组中,从切片的第一个元素开始到底层数组末尾这段范围内的元素个数。 切片 的长度和容量可以分别通过表达式 和 获取。
截取使用的是浅拷贝;但是可以使用 copy 函数将底层数组的一起拷贝(深拷贝) > func main() { > s := []int{2, 3, 5, 7, 11, 13} > s1 = s[0:2] > s2 := make([]int, len(s)) // [0 0 0 0 0 0] > copy(s2, s)// 将 s 的值深拷贝到 s2 中 > s1[0] = 100 > fmt.Println(s) // [100 3 5 7 11 13] > fmt.Println(s1)// [100 3] > fmt.Println(s2)// [2 3 5 7 11 13] > } > ``` > **向切片中添加新元素:** `func append(s []T, vs ...T) []T` > 返回的切片包含**原切片的所有元素及追加值**。(如果底层数组空间不足以容纳所有新增的值,**就会分配一个更大的新数组**。**返回的切片将会指向这个新分配的数组**) > > (切片的更多使用:可以读这篇文章 [Slices: usage and internals](https://go.dev/blog/go-slices-usage-and-internals)) > > ```go > package main > > import "fmt" > > func main() { > var s []int > printSlice(s) // len=0 cap=0 [] > > s = append(s, 0) // 重新赋值给原切片 > printSlice(s) // len=1 cap=1 [0] > > // 自动扩容 > s = append(s, 1) > printSlice(s) // len=2 cap=2 [0 1] > > // 一次性增加多个元素 > s = append(s, 2, 3, 4) > printSlice(s) // len=5 cap=6 [0 1 2 3 4] > } > > func printSlice(s []int) { > fmt.Printf("len=%d cap=%d %v ", len(s), cap(s), s) > } > > ``` **使用make创建切片** > ```go > a := make([]int, 5) // len(a)=5 > ``` > > 可以给`make`传递第三个参数,来指定容量(默认情况下 len = cap) > > ```go > b := make([]int, 0, 5) // len(b)=0, cap(b)=5 > > b = b[:cap(b)] // len(b)=5, cap(b)=5 > b = b[1:] // len(b)=4, cap(b)=4 > ``` > > **切片可以存储任何类型(包括存储其他切片)** > ```go > package main > > import ( > "fmt" > "strings" > ) > > func main() { > // Create a tic-tac-toe board. > board := [][]string{ > []string{"_", "_", "_"}, > []string{"_", "_", "_"}, > []string{"_", "_", "_"}, > } > > // The players take turns. > board[0][0] = "X" > board[2][2] = "O" > board[1][2] = "X" > board[1][0] = "O" > board[0][2] = "X" > > for i := 0; i < len(board); i++ { > fmt.Printf("%s ", strings.Join(board[i], " ")) > } > } > ``` #### Map(映射) ```go package main import "fmt" type Vertex struct { Lat, Long float64 } // 1. 直接声明(var m map[KeyType]ValueType) var m map[string]int // 无法直接使用,需要用 make 开辟空间才能用 m = make(map[string]int, 10) m["go"] = 1 m["java"] = 2 // 2. 使用 make 声明,然后可以直接赋值 m1 = make(map[int]string) m1[1] = "java" m1[2] = "go" m2 = make(map[string]Vertex) m2["Bell Labs"] = Vertex{ 40.68433, -74.39967, } // 3. 声明的同时完成初始化 m3 := map[string]string { "one": "php", "two": "go", "three": "Java" } m4 = map[string]Vertex{ "Bell Labs": {40.68433, -74.39967},// Vertex 这里只表示类型名,可以省略(不省略的写法:"Bell Labs": Vertex{40.68433, -74.39967}) "Google": {37.42202, -122.08408}, } // 遍历 for key, value := range m1 { fmt.Println("key= ", key) fmt.Println("value= ", value) } // 删除 delete(cityMap, "China") // 修改 m["go"] = 0 // 获取 value elem := m["go"] // 可以通过双返回值赋值语句 elem, ok := m[key] 来检查 Map 中是否存在某个键 elem1, ok := m["Java"] // 如果存在这个 key,ok 为 true,否则为 flase // 如果不存在这个 key,elem1 就是当前类型的零值(int 里面就是 0)
使用 Map 实现字母计数
说明: 创建 map: 初始化一个空映射,用于存储每个单词及其出现次数。分割字符串: 将输入字符串按空白字符(空格、制表符、换行等)分割成单词切片。遍历计数:对每个单词,在 map 中将其计数加一。如果单词首次出现,Go 会自动初始化为 0,然后 +1。返回结果:最终返回包含所有单词计数的 map。
Go 语言里也有指针。指针保存的是某个值在内存中的地址。 类型 表示“指向 类型值的指针”,它的零值是 。
**&是取址符,&p取到的是局部变量p的地址 **
*** 是间接寻址符,*p代表取p变量所存地址中的值** (也称为“解引用”/“间接寻址”)
解引用后,可以像操作普通变量一样读写该内存位置的值。
相比于 C,go 不支持指针类型的运算,比如 、、 这是为了安全性和简化内存模型,避免越界访问和复杂错误。 Go 设计哲学是“简单、安全、高效”。指针算术容易出错(如缓冲区溢出),所以被刻意省略了。
函数本身也是一种值。它们可以像其他值一样被传来传去。
函数值可以作为函数的参数,也可以作为函数的返回值。
类型说明零值int / int8 / int16 / int32 / int64整数0uint / uint8 / uint16 / uint32 / uint64 / uintptrbytealias for uint8runealias for int32, represents a Unicode code pointcomplex64 / complex128float32 / float64浮点数0.0bool布尔falsestring字符串""slice切片nilmap映射nilpointer指针nil、 和 类型在 32 位系统上通常是 32 位宽,在 64 位系统上通常是 64 位宽。需要整数值时,应该使用 ,除非你有明确理由使用指定位数或无符号整数类型。
Go 中数据类型的一些特性:零值: for numeric types, for the boolean type, and (the empty string) for strings …… Variables declared without an explicit initial value are given their zero value. vs — 两个分配原语的区别: Go 有两个内存分配函数,作用不同: 特性new(T)make(T, args...)[常用]适用范围任意类型仅 slice / map / chan返回值*T(指针)T(值本身,非指针)初始化清零(只分配内存,填零值)初始化(分配内存并初始化内部结构)使用场景很少直接用,通常用 &T{} 代替slice / map / chan 的标准创建方式
不返回指针的原因:这三种类型本身就是引用类型,底层数据结构已经是指针了 // new:返回指针,内存清零 p := new(int) // p 是 *int,*p == 0 // new 很少单独使用,一般用复合字面量取地址代替: user := &User{Name: "Alice"} // 等价于先 new 再赋值,但更简洁 // make:只用于 slice / map / chan,返回已初始化的值 s := make([]int, 0, 10) // len=0, cap=10 的切片 m := make(map[string]int) // 可用的空 map ch := make(chan int, 5) // 容量 5 的 channel // 常见错误: // var m map[string]int // m == nil,不能直接赋值 // m["key"] = 1 // panic! // 正确写法:m := make(map[string]int)无隐式类型转换: 和 不能直接运算,需显式转换 表达式 能将值 转换为类型 。 一些数值类型转换示例: > var i int = 42 > var f float64 = float64(i) > var u uint = uint(f) > ``` > > 更简单的写法: > > ```go > i := 42 > f := float64(i) > u := uint(f) > ``` - **字符串不可变**:修改字符串需转为 `[]byte` 或 `[]rune` - **`nil` 不能直接用**:切片、map、channel 默认为 `nil`,需初始化才能使用 ### 2.5 自定义类型(Named Types) Go 中有很多预先定义好的类型(`int`、`string`、`[]byte` 等),但你也可以用 `type` 关键字**基于已有类型创建新的命名类型**。 #### 语法 ```go type 新名字 底层类型
① 赋予类型业务含义,提高代码可读性
② 类型安全 — 防止混用
同样是 ,但 和 是不同的类型,不能直接互相赋值:
③ 给类型绑定方法(Go OOP 的基础)
命名类型可以定义方法,这是 Go 面向对象编程的基石:
注意:只能给当前包内定义的类型绑定方法,不能给其他包的类型(包括内置类型 )直接加方法。这就是为什么需要 —— 先创建自己的命名类型,再给它加方法。
Go 1.9 引入了类型别名,语法是 (多一个 ):
绝大多数情况下用的是命名类型(不带 )
命名类型可以和它的底层类型互相转换:
、、 等常见写法 都是 关键字创建命名类型的应用。
注意: 循环的三个表达式不能用括号包裹 和 语句都是可选的
for range 遍历字符串时按 rune(Unicode 码点)迭代,不是按字节:
? 是 Go 对 Unicode 码点 的术语(底层是 )。处理中文、emoji 等多字节字符时,用 而非 。 和 是语句而非表达式,所以不能写成 。Go 没有逗号运算符, 中多变量操作用平行赋值: 和 可以带标签(label),用于跳出外层循环: OuterLoop: for i := 0; i < 5; i++ { for j := 0; j < 5; j++ { if i*j > 10 { fmt.Println("跳出外层循环") break OuterLoop // 跳出外层 for,而不是内层 } } } // continue 也支持标签: NextRow: for i := 0; i < 3; i++ { for j := 0; j < 3; j++ { if j == 1 { continue NextRow // 跳过当前外层循环的剩余迭代 } } } 不带标签只能跳出最内层的 //;带标签可以跳出任意外层。这在嵌套循环中非常实用。
go语言会自动加上 break “The statement that is needed at the end of each case in those languages is provided automatically in Go. Another important difference is that Go’s switch cases need not be constants, and the values involved need not be integers.”
switch 适合每个条件表达式下的执行语句不多、简洁的情况,此时使用 switch 语句可读性好
Go 标准库提供了丰富的实用工具包,大多数日常开发需求无需第三方依赖。
记忆:Go 的格式化时间参考值是 ,对应 递增序列
结构体标签(struct tag) 是 Go 的元编程机制, 指定序列化时的 JSON 字段名。标签格式:,多个标签用空格分隔。
CODE_BLOCK_52
CODE_BLOCK_53包名用途常用函数fmt格式化输入输出Println, Sprintf, Errorfstrings字符串操作Contains, Split, Join, ReplaceAll, Trimstrconv字符串类型转换Atoi, Itoa, ParseInt, FormatFloattime时间处理Now, Format, Parse, Add, Submath数学计算Max, Min, Pow, Sqrt, Absos系统操作ReadFile, WriteFile, Getenv, Argssort排序Ints, Strings, Sliceencoding/jsonJSON 序列化/反序列化Marshal, Unmarshalerrors错误处理New, Is, As, Unwrapsync并发同步Mutex, WaitGroup, Oncecontext上下文控制WithTimeout, WithCancel, WithValueio流式输入输出ReadAll, Copy, WriteString
Go 的语法非常简洁,去掉了许多”样板代码”,并且强制统一的代码风格特性JavaGo (Golang)核心差异点代码组织必须定义在 class 中。直接定义在 package 下,无需类包裹。Go 没有类的概念,只有包(文件)和函数/结构体。变量声明int age = 25; String name = "Go";var age int = 25 name := "Go" (短变量声明)类型后置:类型写在变量名后面。 类型推断::= 是 Go 中最常用的声明方式。常量public static final int MAX = 100;const Max = 100Go 没有访问修饰符,通过首字母大小写控制导出(大写=公开,小写=私有)。分号语句末尾必须加分号 ;不需要手动加分号编译器会自动在行尾插入分号。循环for, while, do-while 三种。只有 forGo 的 for 万能,配合 range 遍历集合。条件判断if (x > 0) { ... }if x > 0 { ... }括号可选,支持初始化语句:if x := f(); x > 0 {}Switch默认会穿透(需要 break)默认不穿透(自动 break更安全,若需穿透需显式写 fallthrough。Case 可以是任意类型。数组/切片int[] arr = new int[5]; List
代码对比示例:
CODE_BLOCK_55 函数名大写:表示当前函数是公有的,相当于 Java 的关键字 函数名小写:表示当前函数是私有的,相当于 Java 的关键字
注意:Go 不允许导入未使用的包 (确保代码干净、无冗余依赖),否则编译报错。
Go 中有一种特殊的函数 ,它不能被手动调用,由 Go 运行时在程序启动时自动执行。每个 文件可以包含多个 函数。
CODE_BLOCK_57
init 函数的执行顺序:
CODE_BLOCK_58
示例:多包依赖下的 init 顺序
CODE_BLOCK_62
init 函数的典型用途:场景示例注册数据库驱动import _ "http://github.com/go-sql-driver/mysql"配置初始化加载配置文件、设置日志级别环境检查校验必要的环境变量是否存在注册到全局工厂模式各插件包通过 init() 将自己注册到主程序的插件注册表中
注意事项: 中不要执行耗时操作(影响启动速度)或可能 panic 的逻辑避免在 中依赖其他包的 (顺序虽然确定,但耦合度高)一个包被多个包导入时,其 也只执行一次开发技巧:用空白标识符临时”使用”未引用的包/变量 Go 严格要求导入的包和声明的变量必须被使用,但开发过程中经常临时注释掉代码。这时可以用 来”占位”: CODE_BLOCK_64 这些只是开发阶段的临时技巧,提交代码前应该清理干净。
关于循环依赖的详细说明和解决方式,见第五章 → 循环依赖。
匿名函数和闭包是 Go 函数式编程的核心工具,也是理解 defer、goroutine 等高级特性的基础
匿名函数即没有名字的函数,可以像普通值一样被赋值、传参和返回(前面 Function values 已经提到过)
CODE_BLOCK_65 匿名函数 + 关键字 = goroutine 是启动并发协程的常用写法。
闭包 = 匿名函数 + 它捕获的外部变量。闭包”记住”的不是外部变量的副本,而是变量的引用——即使外部函数已经返回,闭包仍然能访问和修改那个变量
CODE_BLOCK_66
图解闭包的”绑定”过程:
进阶示例:工厂函数
闭包可以携带配置,返回定制化的处理函数,这就是函数式编程中常见的”工厂”模式:
在循环中创建闭包时,闭包捕获的是循环变量的引用,而不是每次迭代的值:
同样的陷阱也出现在 + goroutine 中: 会出问题。解决方式同上: 或通过参数传递。方面Java(Lambda)Go(匿名函数/闭包)语法(x) -> x + 1func(x int) int { return x + 1 }变量捕获只能捕获 effectively final(不可修改)的局部变量可以捕获并修改外部变量本质语法糖,编译后生成 invokedynamic 指令真·函数值,可赋值、传参、返回立即执行((Supplier) () -> "hi").get()func() { ... }() 直接调用循环陷阱同样存在:lambda 捕获循环变量引用同上,解决方式都是局部快照
语句会将一个函数的执行延迟到外围函数返回时才进行,常用于资源清理(文件、锁、连接)(类似 Java 中的 finally)
被延迟调用的函数,其参数会立即求值,但函数调用本身要等到外围函数返回时才会执行。
注意:参数在 声明时立即求值多个 按后进先出顺序执行 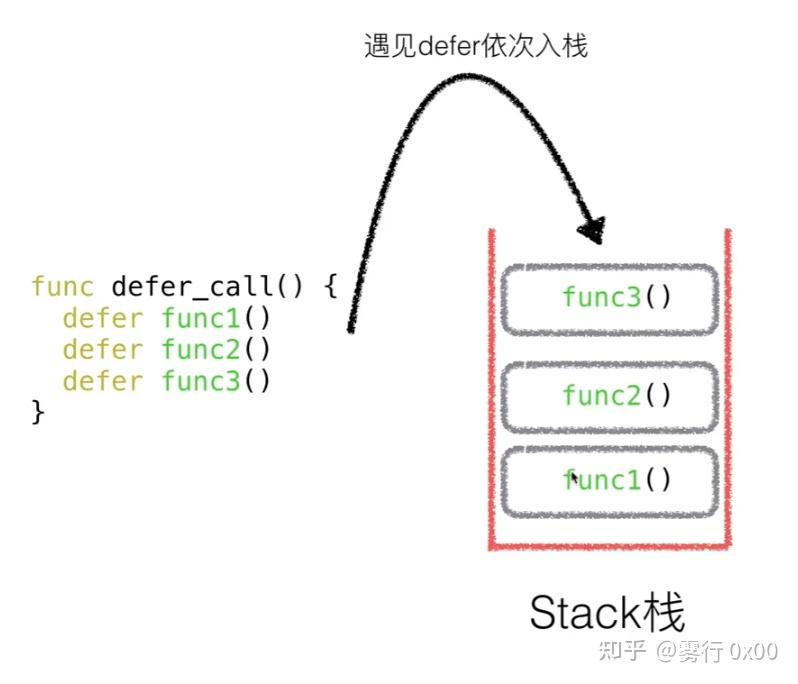
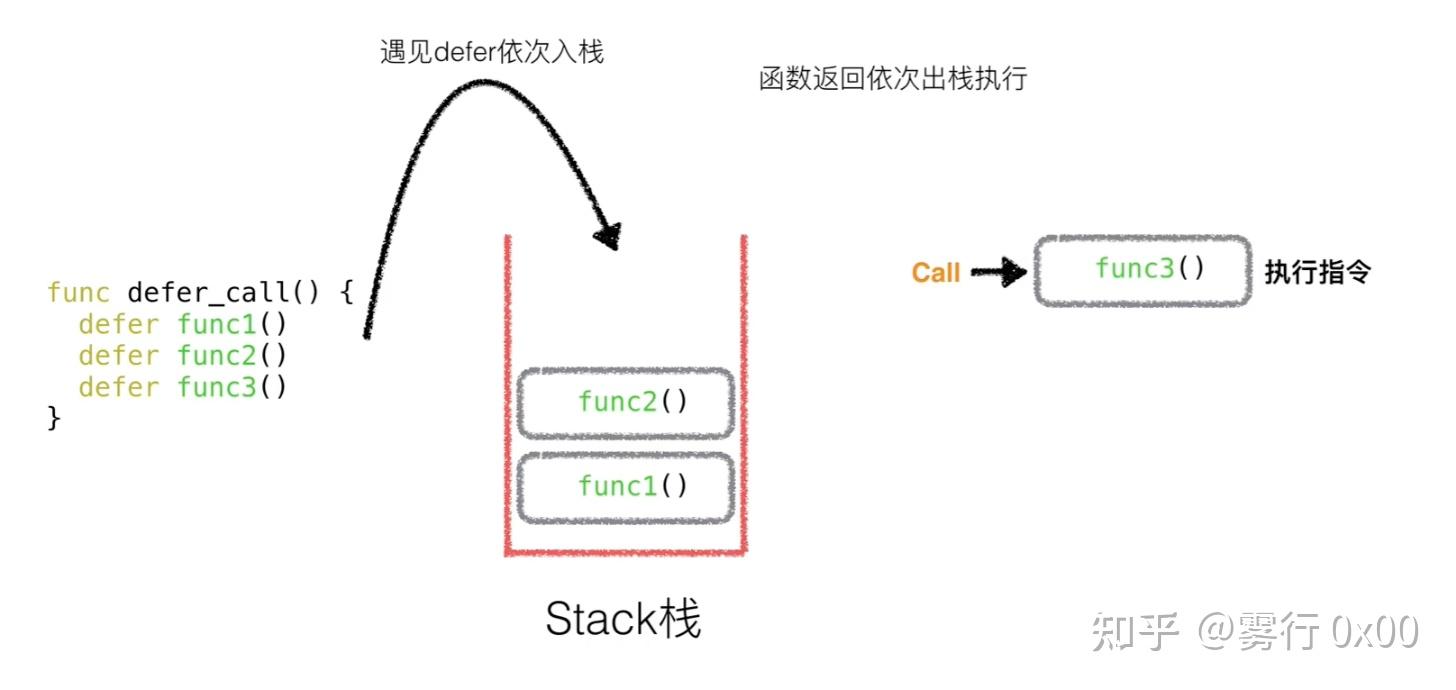
defer 在 return 之后被调用 CODE_BLOCK_72 return 不是一个原子操作,分三步:先计算并设置返回值;然后执行已注册的 ;最后函数才真正结束 把结果返回给调用方。 CODE_BLOCK_73 结果: 函数返回值是 ,但函数结束前局部变量 最后会被改成 。 执行过程 注册延迟调用 先执行 把 改成 ,并返回 这时返回值已经确定为 真正返回前,执行 把 改成 函数返回
结果 局部变量 最后是 函数返回值是
( 得到的返回结果已经先拷贝出去了,所以最终返回的仍然是 20,不是 10)
Go 的函数是一等公民,但在定义、返回值和错误处理上与 Java 有显著不同。特性JavaGo (Golang)核心差异点定义位置必须在类内部可以在包级别直接定义函数不依附于对象存在多返回值不支持(需返回对象、Map 或数组)原生支持经典模式:(结果, error)命名返回值不支持支持可在函数签名中给返回值命名,return 时可省略变量名可变参数void func(String... args)func func(args ...string)语法相似,传递切片时 Go 需要 ... 展开延迟执行无内置关键字(需 try-finally)defer 关键字defer 注册的函数在当前函数返回前执行(LIFO)错误处理try-catch-finally 异常机制显式返回 errorGo 没有 Exception。错误也是值,需手动 if err != nil 判断函数重载支持(同名不同参)不支持需改名(如 ParseInt, ParseFloat)或利用可变参数/接口
代码对比示例:
CODE_BLOCK_74
Go 没有传统意义上的”类”,但可以通过结构体(struct) 和 方法(method) 实现面向对象特性。OOP 特征Go 的实现方式与传统 OOP(Java/C++)的区别封装结构体 + 首字母大小写(类名、方法、属性)控制可见性(大写=导出,小写=私有)无 public/private/protected 关键字,无类作用域继承结构体匿名嵌入(组合)无 extends,通过组合复用字段和方法,Go 没有父子类型层级多态接口隐式实现(Duck Typing)无需 implements 声明,只要方法签名匹配即视为实现了接口构造NewXxx() 工厂函数(惯例)无构造函数重载,结构体直接用字面量 Type{...} 初始化方法函数 + 接收者(func (t Type) Method())方法定义在结构体外部,通过接收者参数绑定到类型抽象接口(Interface)只有方法集合约束,无抽象类、无字段约束、无 abstract 关键字静态成员包级别变量/函数无 static 关键字,直接在包内定义函数或变量即可 Go 面向对象的设计哲学:组合优于继承,接口隐式满足,简单胜于复杂。下面逐一展开
结构体是一系列属性的集合
CODE_BLOCK_75首字母大写:表示可公共访问;小写:当前包私有
CODE_BLOCK_76
标签是附加在结构体字段上的元数据,用反引号 包裹,格式为 ,多个标签用空格分隔。标准库和第三方库通过反射读取标签来实现序列化、校验、ORM 映射等功能。(有点类似 Java 里面的注解,都是给程序看的,不是业务逻辑本身)某些标准库或第三方库约定会去读取这些标签,所以当你想让这些库按你的意图工作时,就需要在结构体字段上写 tag 例如 1. JSON 序列化 如果你用 ,可以写: > type User struct { > Name string `json:"name"` > Age int `json:"age"` > } > ``` > > 这样序列化出来就是: > > ```json > {"name":"Alice","age":30} > ``` > > 如果**不写 tag**,默认通常会用字段名: > > ```json > {"Name":"Alice","Age":30} > ``` > > ##### 2. 数据库 / ORM > > 有些 ORM 或数据库映射库会看: > > __CODE_BLOCK_80__ > > 意思是:结构体字段 `Name` 对应数据库列 `username`。 > > ##### 3. 参数校验 > > 有些校验库会看: > > __CODE_BLOCK_81__ > > 表示这个字段必填、年龄最小值是多少 __CODE_BLOCK_82__ **常见标签用途:** | 标签用途 | 示例 | 说明 | | -------- | ---- | ---- | | `json` | `json:"name,omitempty"` | 序列化字段名;`-` 忽略;`omitempty` 空值时省略 | | `xml` | `xml:"name,attr"` | XML 序列化 | | `db` | `db:"user_id"` | database/sql 等 ORM 的数据库列名映射 | | `validate` | `validate:"required,min=1"` | go-playground/validator 校验规则 | | `form` | `form:"username"` | gin 等框架的 HTTP 表单参数绑定 | | `yaml` | `yaml:"name"` | YAML 序列化 | > 标签是**编译时不会校验的字符串**,写错了不会报错,只在运行时通过反射读取时才会发现问题。如需读写标签,参见[反射章节](#5-反射reflect)的 `field.Tag.Get()`。 ### 2. 方法绑定 ```go type Person struct { FirstName string LastName string Age int } // 值接收(复制副本)—— 可以用于读操作,无法修改原始值【相当于值传递】 func (p Person) FullName() string { return p.FirstName + " " + p.LastName } // 指针接收(可修改原值)—— 需要修改结构体字段时使用【相当于引用传递】 func (p *Person) SetAge(newAge int) { p.Age = newAge } func (p *Person) Birthday() { p.Age++ // 指针接收者,可以直接修改原值 } // 使用示例 func main() { p := Person{FirstName: "张", LastName: "三", Age: 25} // 值接收:p 和指向 p 的指针都可以调用 fmt.Println(p.FullName()) // "张 三" ptr := &p fmt.Println(ptr.FullName()) // "张 三"(Go 自动解引用,等价于 (*ptr).FullName()) // 指针接收:只有可寻址的变量能调用 p.SetAge(30) fmt.Println(p.Age) // 30(原值已修改) p.Birthday() fmt.Println(p.Age) // 31 // ⚠️ 值接收者不会修改原值 // 这里修改的只是副本,原 p 不变 — 详见上方「结构体的值传递和引用传递」 }
相当于类的方法不在类里面,而是通过 的方式绑定到类型上。接收者变量名习惯用类型首字母小写(如 、)
选择指南:场景选择原因需要修改原值指针接收者值接收者操作的是副本结构体较大指针接收者避免复制整个结构体的开销只读 / 小结构体值接收者简单安全,无副作用实现接口的方法保持一致同一类型的方法接收者类型应统一基本类型的别名类型值接收者本身很小,无需指针Go 的自动转换:当你用 时,Go 会自动将指针 解引用为 ;当你用 时,Go 会自动取地址 。 了解:方法可以定义在任意命名类型上(不只是结构体)。只要类型不是指针或接口,就可以绑定方法: CODE_BLOCK_84 ? 这意味着 Go 中几乎任何类型都可以拥有方法和实现接口——int 可以格式化输出,slice 可以变成 io.Writer,函数可以变成 HTTP handler。这种灵活性是 Go 组合式设计的基石。
CODE_BLOCK_85
Go 组合 vs Java 继承:特性Java 继承Go 组合(嵌入)关系Dog is a Animal(父子关系)Dog has a Animal(包含关系)类型系统子类可以赋值给父类引用(向上转型)Dog 和 Animal 是不同类型,不能互赋方法提升@Override 全覆盖可重写,也可显式调 d.Animal.Speak()多继承不支持(只能单继承)可嵌入多个结构体构造链super() 调用父类构造手动初始化嵌入字段 Go 的组合不是继承的语法糖,它不会建立类型层级。如果你想用 Dog 替代 Animal(比如作为函数参数),需要通过接口来实现多态——详见下一节。
嵌入结构体时,被嵌入类型的方法会被”提升”到外层,外层类型也自动实现被嵌入类型满足的接口:
接口也可以嵌入: 就是嵌入了 和 两个接口,而不是重复声明 和 方法。
当嵌入的多个类型有同名方法/字段时:外层声明的方法/字段遮蔽内层同名项同一嵌套层级的同名项会引发编译错误(除非从不在类型定义之外被使用)
接口是 Go 实现多态的核心机制。与 Java 不同,Go 采用隐式实现:只要一个类型的方法集覆盖了接口的所有方法,它就自动实现了该接口,无需显式声明 。
每个接口变量内部由一个 元组表示:
CODE_BLOCK_87概念英文含义确定时机静态类型static type变量声明时的类型,即接口类型本身(如 Speaker)编译时具体类型concrete type / dynamic type接口变量实际持有的底层值的类型(如 Dog)运行时
类比:接口变量就像信封,信封类型(Speaker)永远不变,但信封里装的内容(Dog / Cat)可以动态替换。类型断言就是拆开信封看里面是什么。
不过如果某个结构体没有完全实现接口的所有方法,接口类型就不能接收该结构体的实例
接口实现规则(重要):接收者类型接口变量能持有的值1. 值接收者T 和 *T 都满足接口2. 指针接收者只有 *T 满足接口,T 不满足值接收者
CODE_BLOCK_90指针接收者
CODE_BLOCK_91 ? 记忆口诀:指针接收者的方法,只能通过指针调用;值接收者的方法,值和指针都能调用。
空接口没有任何方法,因此所有类型都实现了它,类似 Java 的 。
Go 提供了类型断言的机制,能判断接口变量的具体类型:
CODE_BLOCK_93
Go 标准库定义了一些轻量接口,实现它们即可融入整个生态:接口方法签名作用实现示例fmt.StringerString() string控制 fmt.Print 的输出格式自定义类型的打印errorError() string表示错误值errors.New()、自定义错误类型io.ReaderRead([]byte) (int, error)读取数据流文件、网络连接、strings.Readerio.WriterWrite([]byte) (int, error)写入数据流文件、网络连接、bytes.Buffersort.InterfaceLen() / Less() / Swap()自定义排序任意切片的排序
Go 的接口是隐式实现的,有时候没有静态转换让编译器帮你验证”某个类型确实实现了某个接口”。可以用空白标识符做编译时断言:
这行代码不会创建任何变量( 丢弃了值),但如果 没有实现 ,编译就会报错。这种写法常用于库的内部实现中,确保接口契约不因重构而破坏。
如果一个类型只是为了实现某接口而存在,且不会暴露给其他包,那就只需要暴露接口,私有化具体类型:
使用方这样调用:
好处: 和 都是小写,包外完全不可见,无法被外部直接创建调用方只依赖 接口,要替换实现只需改构造函数调用,其余代码不变相当于把”依赖倒置原则”做在了语言层面
原则:接受接口,返回结构体 是默认规则;当类型的存在意义就是实现某个接口时,返回接口来隐藏实现是合理的例外。
反射让你在运行时检查和操作未知类型的变量。当你不确定传入的数据是什么结构时(比如写框架、ORM、序列化库),就需要用到它。 类比 Java 中的反射操作: + 。 注意:反射代码可读性和性能都不如静态代码,能用接口解决的优先用接口。Go 标准库中 、 等大量依赖反射,但普通业务代码应该慎用。
1. 遍历结构体字段(读取 struct tag)
2. 获取和修改字段值
3. 动态调用方法
函数 / 方法作用reflect.TypeOf(v)获取类型信息reflect.ValueOf(v)获取值信息t.Kind()底层种类(Int, String, Struct, Ptr…)t.NumField() / t.Field(i)遍历结构体字段t.Field(i).Tag.Get("json")读取 struct tagv.Elem()解引用指针,拿到指向的实际值v.FieldByName("X")按名字获取字段值v.SetInt(n) / v.SetString(s)修改值(需 CanSet())v.MethodByName("X").Call(args)按名字调用方法v.Interface()将 reflect.Value 还原为 interface{} 概念层面的差异参见本章开头的概览表,下面通过一段等价代码直观感受两种语言的组织方式差异。
Java 方式:
Go 方式:
CODE_BLOCK_104
同样实现 Animal/Dog/Speak,Java 用了 class + extends + @Override,Go 用了 struct + 嵌入 + 方法绑定
Go 不使用异常,而是通过返回 类型来处理错误。这是 Go 与 Java 最显著的差异之一
CODE_BLOCK_105
CODE_BLOCK_106
CODE_BLOCK_107
CODE_BLOCK_108
最佳实践:业务逻辑错误用 返回 仅用于不可恢复的错误(如配置错误、数据不一致)优先使用 和 进行错误判断特性JavaGo (Golang)核心差异点错误类型Exception 类层次结构error 接口Go 的错误是值,不是控制流抛出方式throw new Exception()return errors.New()Go 错误作为返回值显式传递捕获方式try-catch-finallyif err != nilGo 需手动检查每个错误受检异常支持(必须捕获)不支持Go 所有错误都是”非受检”的错误链getCause()errors.Unwrap()Go 1.13+ 支持错误包装finallyfinally 块deferdefer 更简洁,但功能略有不同异常传播自动向上抛手动返回错误Go 需要逐层返回错误
代码对比示例:
Go 的依赖管理经历了两个阶段:早期的 GOPATH 模式和现代的 Go Modules 模式。
GOPATH 是 Go 最早的依赖管理方式
GOPATH 是一个环境变量,指向你的”工作区”(workspace)。所有 Go 代码和依赖都必须放在 目录下才能正常编译和引用第三方包**。Go 编译器查找依赖时,直接去 (标准库)下找。
CODE_BLOCK_112
做的事情很简单:把远程仓库的源码 clone 到 里,不能用自己习惯的目录。Git 仓库也要在 下,非常别扭 | | 单一工作区 | 所有项目共享同一个 ≈ (本地缓存)Module 和 Package 的关系:一个 Module 可以包含多个 Package,每个子目录对应一个 Package。Module 是发布和版本管理的单位,Package 是代码组织的单位。
只列直接依赖。间接依赖由 Go 自动管理,在 时补全。
是 的伴侣文件,记录每个依赖版本的密码学哈希(SHA-256),用于:完整性校验:下载的包是否被篡改安全审计:每次构建都验证依赖的哈希是否匹配
Go 不选”最新版本”,而是选”所有依赖都兼容的最低版本“——这叫 MVS(最小版本选择)。
这与 npm 的”选最新版本”不同。MVS 的好处是确定性:相同 永远得出相同的依赖版本,构建结果可复现。
Go 团队维护了官方模块代理 ,你的依赖不直接从 GitHub 拉,而是通过代理:
CODE_BLOCK_117
这解决了”上游仓库删库跑路”的问题——代理会永久缓存已发布的版本。
CODE_BLOCK_118 依赖默认下载到 | 模块本地缓存目录 | | | 空 | 允许通过 HTTP(非 HTTPS)拉取的模块路径模式 | | | 空(Go 1.22+) | 跳过 go.sum 校验的模块路径模式 | | | 空 | 指定 go.work 文件路径(workspace 模式) |
GO111MODULE — 控制模块模式开关
Go 1.16 起默认值为 ,正常情况下不需要手动设置。
GOPROXY — 模块代理
CODE_BLOCK_120
的含义:如果代理上没有这个模块,直接去源仓库(GitHub 等)拉取。多个代理地址按顺序尝试,第一个不可用就试下一个。
GOPRIVATE — 私有模块配置(最常用)
公司内部的私有仓库不走公共代理,也不上传校验和:
配合 Git 认证:私有仓库通常需要配置 或 SSH key,或者设置 。
GOMODCACHE — 模块缓存位置
类比 Java 的 。所有项目的依赖共享这个缓存,不会重复下载。
CODE_BLOCK_123场景推荐配置国内开发GOPROXY=https://goproxy.cn,direct公司内网 + 私有 GitLabGOPRIVATE=http://gitlab.mycompany.com离线 / 内网开发配合 go mod vendor + GOPROXY=off调试模块下载问题GOPROXY=direct 排除代理干扰规则说明包名与目录名一致,通常小写,简短可见性首字母大写 = 导出(公有),小写 = 私有文件组织同一目录下所有 .go 文件必须属于同一个包main 包可执行程序必须包含 package main 和 func main()循环依赖严格禁止,编译直接报错 import cycle not allowed
CODE_BLOCK_124 导入语法的各种写法(单行/分组/别名/匿名/点导入)和 init() 函数详解见第二章 → init 函数与 import 导包,此处不再重复。
Go 严格禁止包之间形成循环依赖(A import B, B import A),编译直接报错。
CODE_BLOCK_125
解决方式:提取公共接口/类型到第三个包(C 包),A 和 B 都依赖 C通过接口解耦:A 定义接口,B 实现接口,避免 B import A合并为一个包(如果耦合确实紧密)特性Java (Maven/Gradle)Go (Go Modules)核心差异点配置文件pom.xml / build.gradlego.mod + go.sumGo 配置更简洁版本策略选最新兼容版本MVS(最小版本选择)保证构建可复现依赖下载mvn install / gradle buildgo get / go mod tidyGo 无需构建工具远程仓库Maven Central / jcenterhttp://proxy.golang.org(官方代理)Go 代理防仓库删除本地缓存~/.m2/repository$GOPATH/pkg/mod都是全局缓存传递依赖自动解析自动解析两者都支持多模块父子 POMGo 1.18+ workspaceGo workspace 设计更轻量项目位置任意目录任意目录Go Modules 时代不限位置,GOPATH 时代必须放 src/ 下循环依赖Maven 编译不会报错(但可能运行时出问题)编译报错Go 强制单向依赖
代码对比示例:
Go 的并发模型基于 CSP(Communicating Sequential Processes) 理论,核心是 和 。这是 Go 最强大的特性之一
传统多线程编程(Java/C++)的核心模式是共享内存 + 锁——多个线程访问同一块数据,用互斥锁保护。这种模式容易出错:忘记加锁 → 数据竞争,加锁顺序不对 → 死锁。
==传统的做法:通过共享内存来通信==
CODE_BLOCK_128
==Go 的做法:通过通信来共享内存==
CODE_BLOCK_129“Don’t communicate by sharing memory; share memory by communicating.”
Goroutine 是 Go 中的并发执行单元,由 Go 运行时而非操作系统调度:对比维度Java 线程Go Goroutine创建者JVM → OS 内核Go 运行时(用户态)初始栈大小~1 MB(固定)~2 KB(可动态扩容)切换成本内核态切换(~1-10μs)用户态切换(~0.2μs)创建数量数百~数千轻松数万~数十万线程池需要手动管理(ExecutorService)运行时自动调度,无需关心通信方式shared memory + lockchannel + select
关键字:在任意函数调用前加上 就能启动一个 goroutine,无需定义线程类、无需实现 Runnable——这是语言级别的并发支持。
CODE_BLOCK_130所有 goroutine 都依赖于整个进程 , 函数结束会导致进程结束=>所有 goroutine 一起退出 Java 开发需要”申请线程 → 提交任务 → 等待结果 → 回收线程”。 Go 中只需 ,运行时自动完成调度和复用,能更多的把注意力放在协程间的数据流上。
Go 的调度器采用 GMP 模型,将 goroutine 高效地映射到操作系统线程上,是整个并发系统的基础。角色全称本质数量职责GGoroutine协程任务数万~数十万封装一段待执行的代码 + 栈 + PC 寄存器MMachineOS 线程动态增减(上限 SetMaxThreads)真正执行 G 的载体,直接对接内核PProcessor逻辑处理器= GOMAXPROCS(默认 CPU 核数)持有 G 的本地队列,是 M 和 G 之间的桥梁
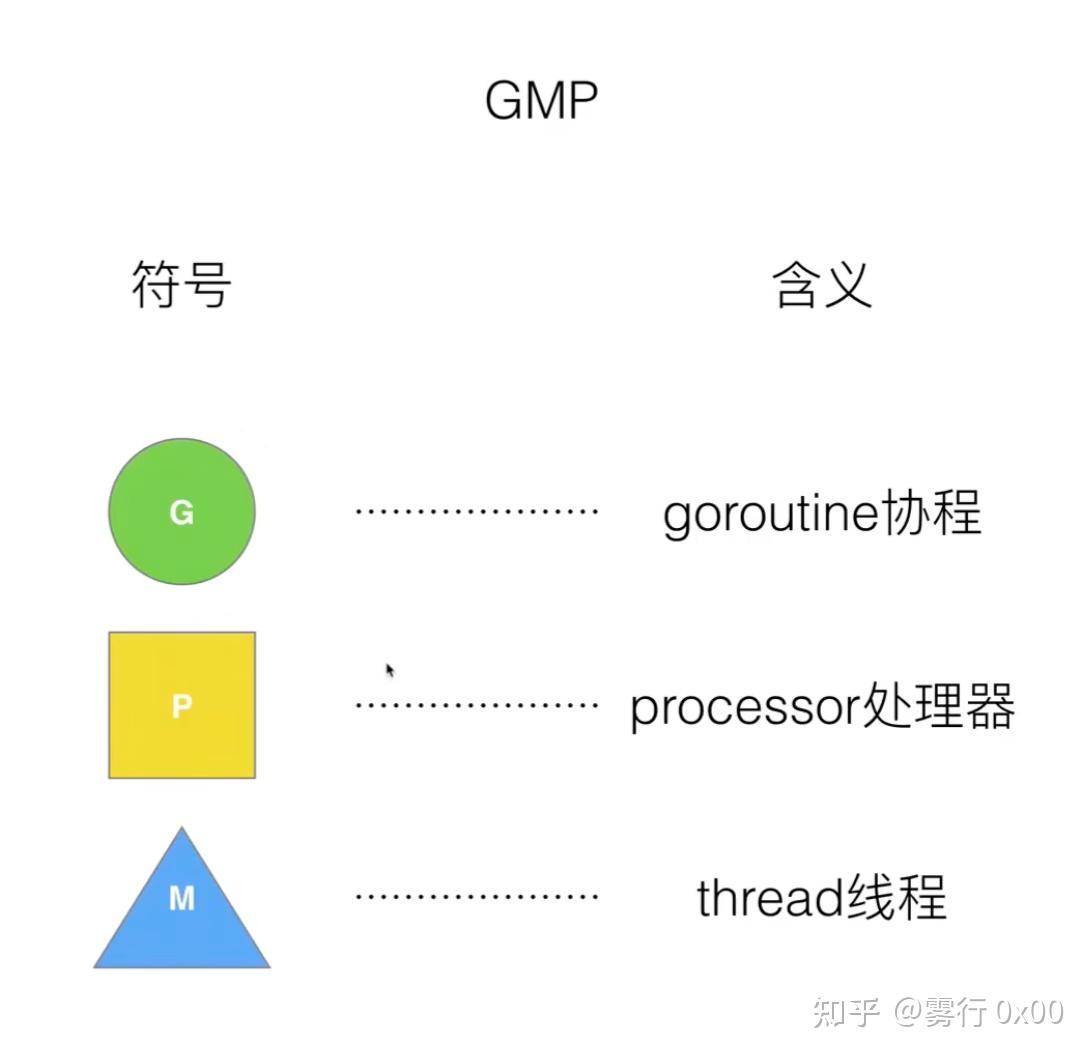
默认状态(每个 P 绑定一个 M):创建 goroutine 时,G 优先放入当前 P 的本地队列绑定的 M 从 P 的本地队列按轮转顺序取 G 执行本地队列满了,放一半到全局队列
1. 并行
Go 调度器不只是把 goroutine 来回切换着跑,而是通过设置多个 P,尽量让它们真正分散到多个 CPU 核上同时跑,从而提升吞吐量和执行效率 最大并行数由 P 的最大数量(GOMAXPROCS)决定:如果 ,即使你开了 10000 个协程,同一时刻也只有 1 个在真正占 CPU 跑
2. Work Stealing 机制 和 全局 G 队列
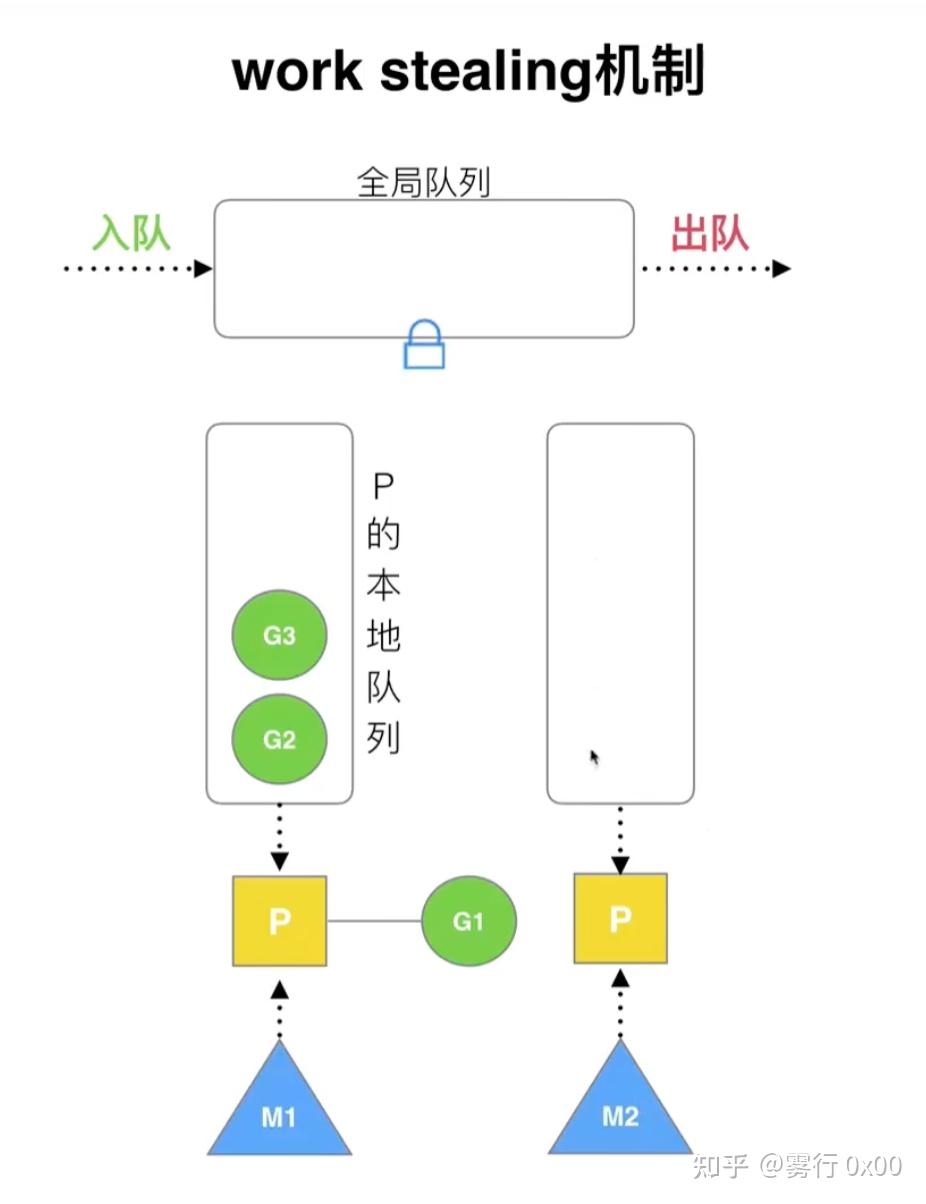
场景:M1 忙碌、M2 空闲 无任务需要处理此时 M2 会先尝试从其他 P 偷一半 G 来处理,如果其他队列也没有,就会从全局队列获取(需要加锁)
3. hand off 机制
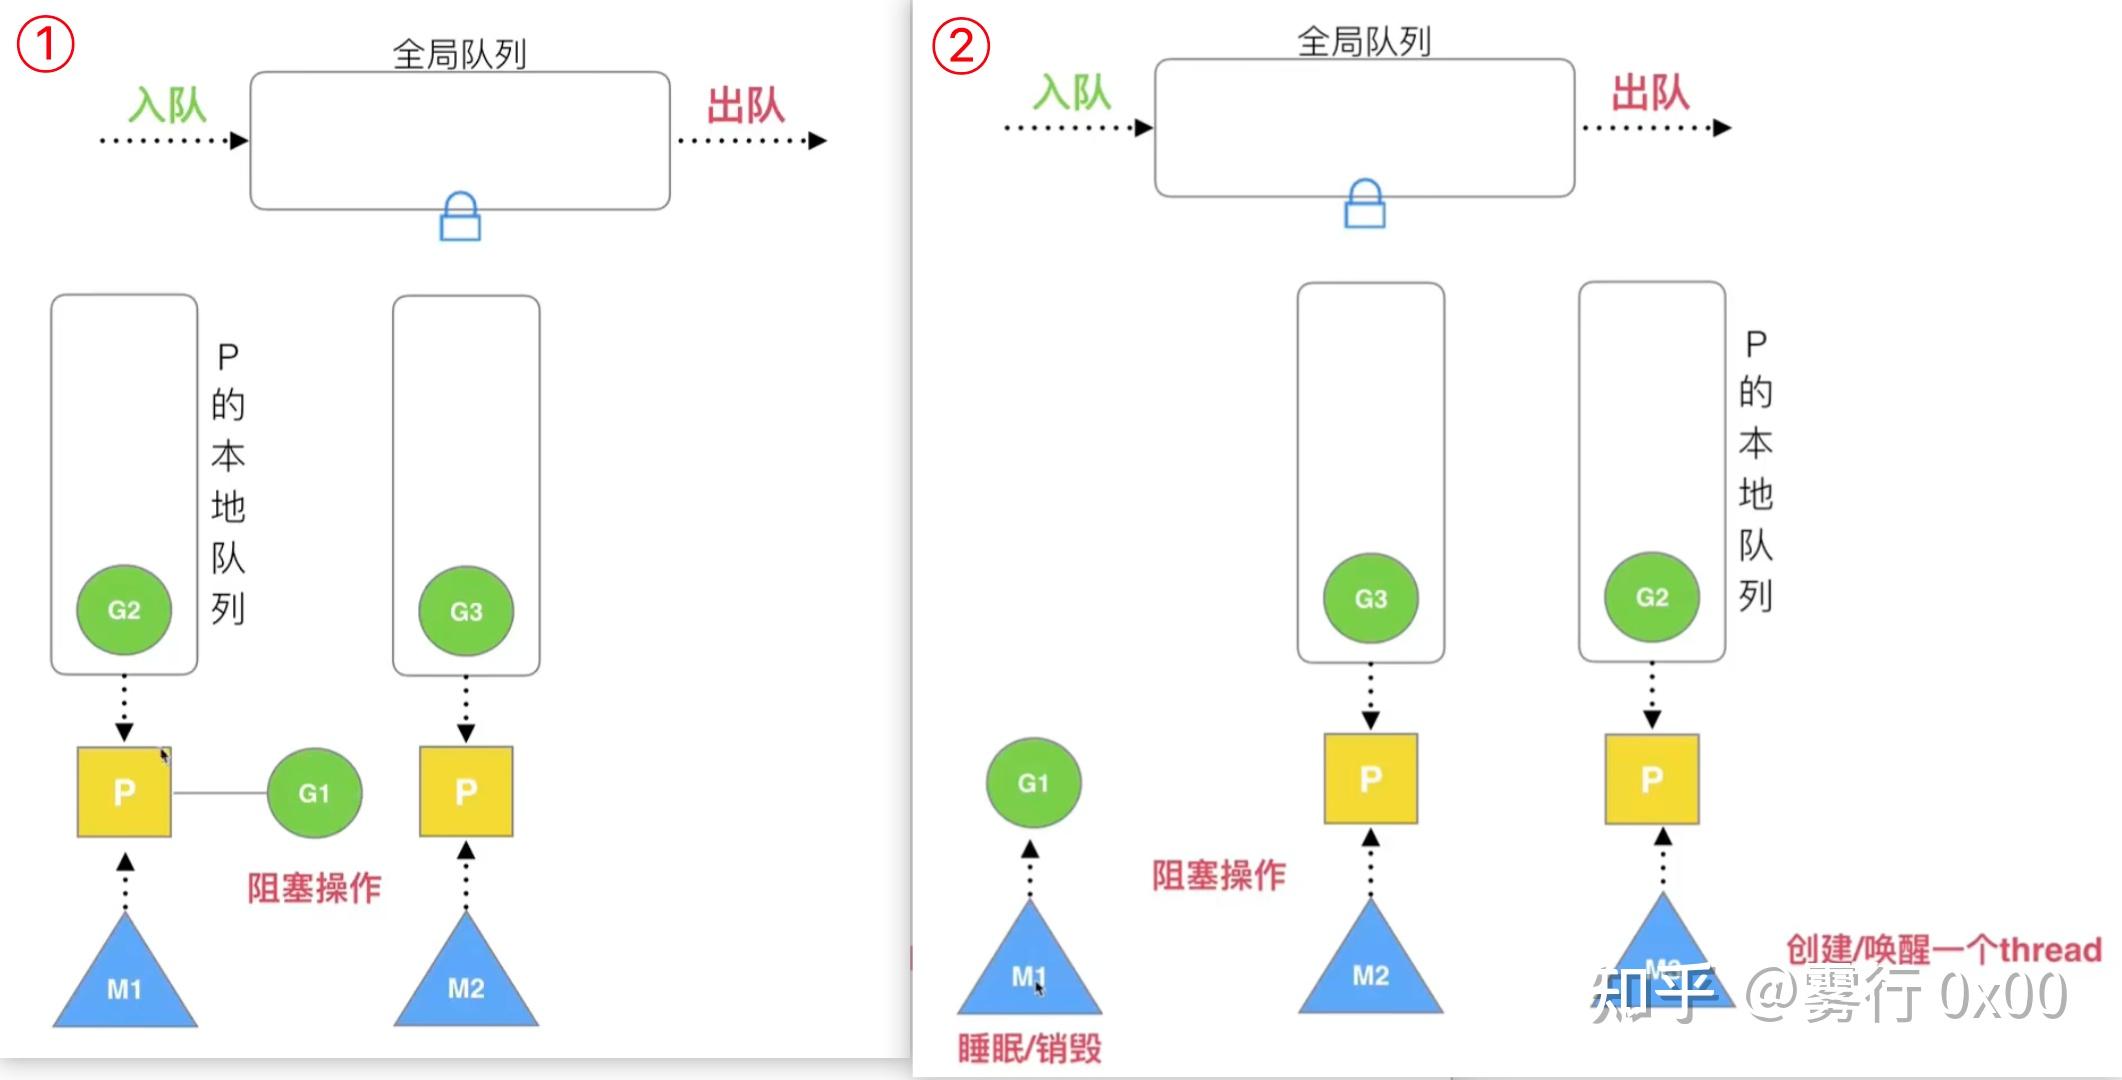
场景:G1 任务进入阻塞状态,为了充分利用 CPU,此时会新创建一个 M3,将 P 交接()给新的 M3此时 M1 没有绑定 P,会进入睡眠/销毁,如果 G1 阻塞结束还需要继续执行,就会进入其他队列中
4. 抢占式
每个 G 最多容许运行 10ms → 超出 10ms,新的 G 会抢占 CPU(原有的 G 放回队列等待)维度JavaGo调度层级内核线程 1:1 用户线程G(协程) : M(线程) = N:1,通过 P 解耦上下文切换内核态,每次 ~1-10μs用户态,每次 ~0.2μs阻塞处理线程阻塞 → 浪费内核资源G 阻塞 → M 继续执行其他 G队列模型单一全局阻塞队列每个 P 有本地队列 + 全局队列 + work stealing抢占机制依赖 JVM safepointGo 1.14+ 基于信号的异步抢占 Go 通过引入 P 这一层间接,实现了 M 和 G 的解耦——这是它能在数万 goroutine 下保持高效的关键。Java 的虚拟线程(Project Loom, Java 21+)借鉴了类似思路。
Channel 是 Go 实现 CSP 并发模型的核心——它是 goroutine 之间传递数据的管道。前面讲过,Go 的并发哲学是”通过通信来共享内存”,channel 就是这个”通信”的载体。
可以把 channel 理解为一根类型安全的管道(类似于 Java 的 ,但它是语言内置的,不需要 任何包):
关键特性:类型安全: 只能传 int, 只能传 string并发安全:多个 goroutine 可以同时读写同一个 channel,Go 运行时保证原子性,无需加锁FIFO 顺序:先发送的数据先被接收(队列语义)
CODE_BLOCK_132
发送和接收时的阻塞行为取决于 channel 的缓冲类型:
无缓冲 Channel()— 同步通信
无缓冲 channel 的发送和接收是同步发生的:发送方必须等接收方准备好(发送方发送完数据到 channel 之后,也会阻塞 等待接收方收到数据),接收方也必须等发送方发送(如果此时 channel 为空,就会阻塞 等待发送方放入数据)。 类比 4x100 接力赛 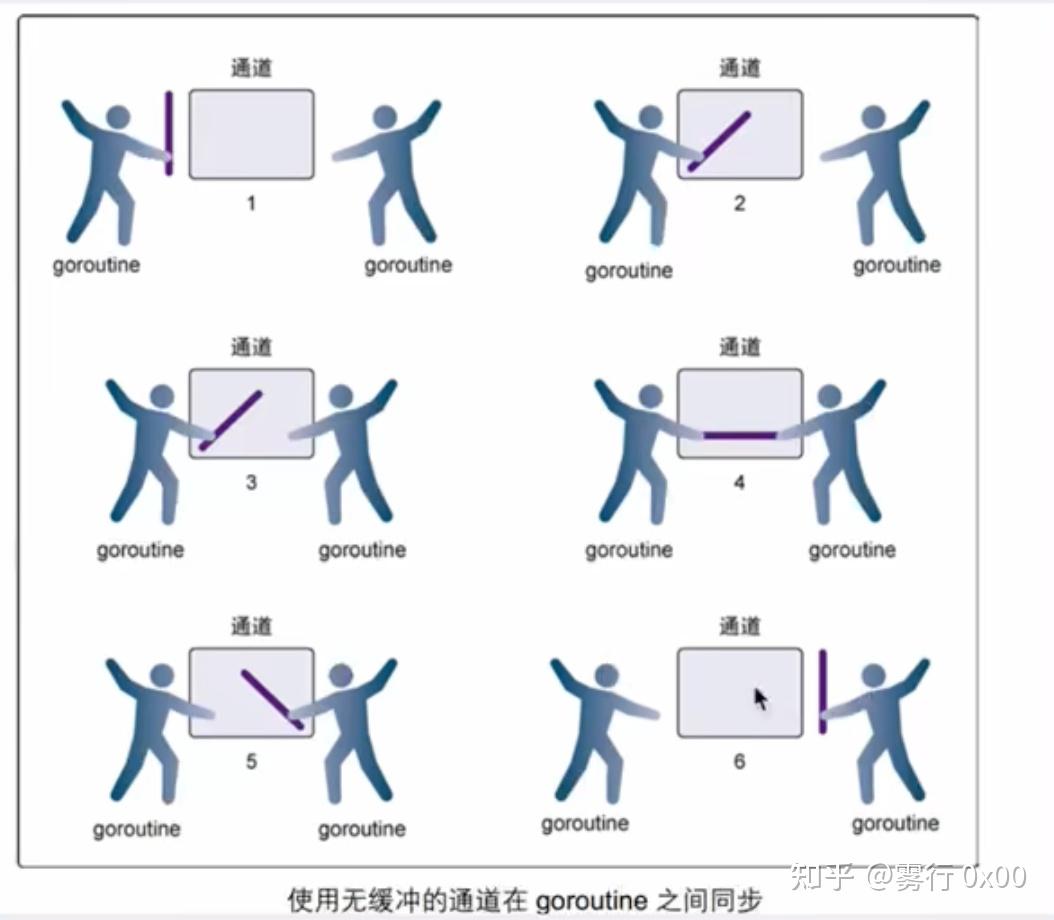
? 无缓冲 channel 天然提供了同步语义:发送方知道接收方已经拿到数据了,这本身就是一种”确认”机制(”我发出去了,而且你一定收到了”)。
有缓冲 Channel()— 异步通信
有缓冲 channel 内部有一个环形队列。发送方在缓冲区满之前不会阻塞;接收方在缓冲区空之前不会阻塞。 类比:缓冲区起到快递柜的作用 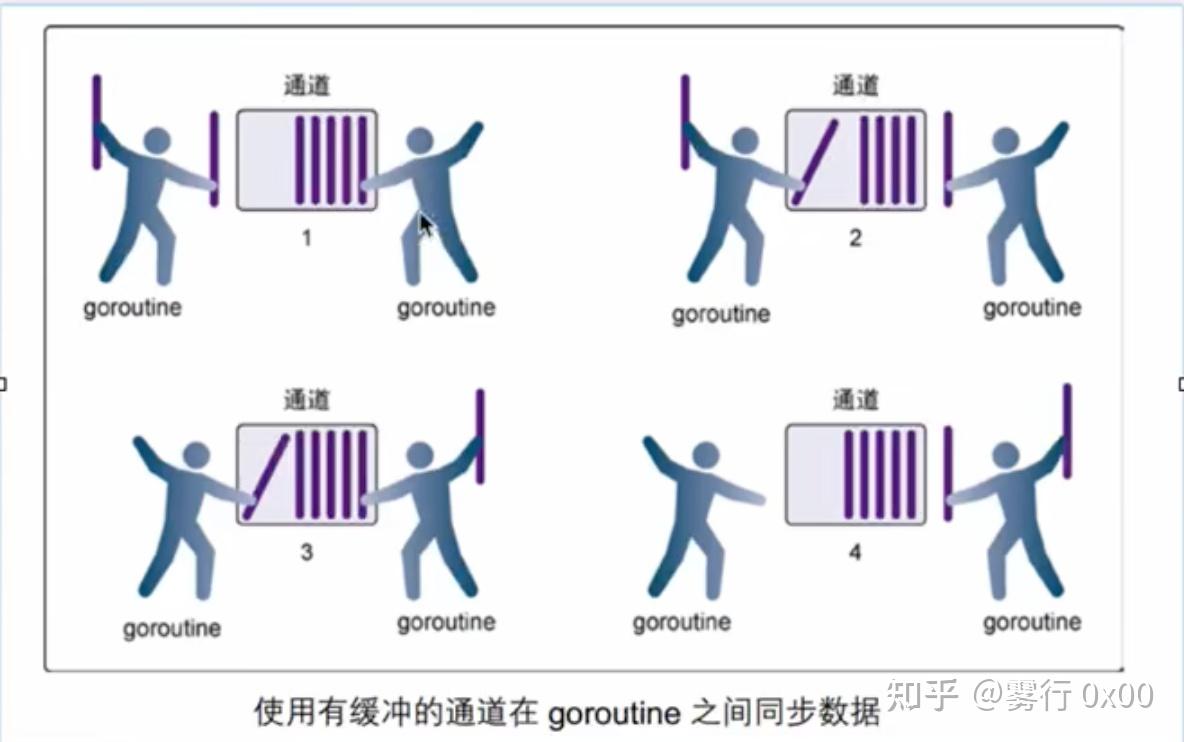
CODE_BLOCK_135
选择指南:场景推荐原因需要”发完即确认收到”无缓冲同步语义,天然确认生产者-消费者,速率不匹配有缓冲缓冲区吸收突发流量信号通知(”任务做完了”)无缓冲 或 chan struct{}只需同步,不需传数据限流 / 令牌桶有缓冲buffer 大小 = 并发上限
在函数签名中使用单向 channel,让编译器帮你检查数据流向:
? 单向 channel 就像 Java 中的 / 通配符——在 API 层面约束数据流向,防止误用。实际使用的还是同一个双向 channel,只是函数看到的”视角”不同。
CODE_BLOCK_137关于关闭 channel channel 不像文件一样经常需要关闭,当你确实没有任何需要发送的数据/你想显式地结束循环,才去关闭 channel关闭 channel 后,可以继续从 channel 接收数据、无法向它发送数据
以下场景没有使用 range 循环,如果写入完毕没有关闭 channel 就会出现死锁 CODE_BLOCK_138
场景一:goroutine 间传递数据(最基础)
CODE_BLOCK_139
场景二:信号通知 / 同步等待
场景三:超时控制(配合 select)
陷阱一:向已关闭的 channel 发送 → panic
陷阱二:死锁 — 无缓冲 channel 没有配对
陷阱三:nil channel 永久阻塞
CODE_BLOCK_144
陷阱四:range 不会自动退出 — 忘记 close
维度Java BlockingQueueGo Channel类型安全泛型
单流程下一个 go 只能监控一个 channel 的状态,而 select 可以实现监控多个 channel 的状态
如果多个 channel 都可接收到数据, 会随机选择可用的 case
CODE_BLOCK_147
最佳实践: 优先使用 进行通信,而非共享内存使用 控制 goroutine 生命周期避免 goroutine 泄漏(确保所有 goroutine 能退出)
特性JavaGo (Golang)核心差异点并发单元Thread / ExecutorServiceGoroutineGo 协程更轻量,创建成本低通信方式共享内存 + 锁Channel + syncGo 提倡”通过通信共享内存”线程池ThreadPoolExecutorGo 运行时自动调度Go 无需手动管理线程池同步原语synchronized, Lock, SemaphoreMutex, WaitGroup, ChannelGo 原语更简洁超时控制Future.get(timeout)context.WithTimeoutGo 的 context 更灵活并发安全需手动保证需手动保证两者都需要开发者注意调试难度较复杂(线程 dump)较复杂(goroutine dump)Go 提供 pprof 工具
代码对比示例:
CODE_BLOCK_149
文件命名以 结尾,测试函数以 开头:
CODE_BLOCK_150
参数说明-bench=.运行所有 benchmark-benchmem显示内存分配统计-count=5运行 5 次取平均-cpuprofile生成 CPU 性能分析文件
工具用途命令go test运行测试go test -vgo test -race检测数据竞争go test -racepprof性能分析go tool pprofdelve调试器dlv debuggo vet代码检查go vet ./...
CODE_BLOCK_154特性Java (JUnit)Go (testing 包)核心差异点测试框架JUnit, TestNG内置 testing 包Go 无需额外依赖断言库AssertJ, Hamcrest标准库 + testifyGo 常用第三方断言库MockMockitogomock, testify/mockGo 需第三方库性能测试JMH内置 BenchmarkGo 更简单易用覆盖率JaCoCo内置 coverGo 内置支持并行测试@Parallelt.Parallel()两者都支持表格测试参数化测试表格驱动测试Go 更灵活
使用 (或 )统一代码风格。Go 采取了一种不寻常的方式:让机器处理大多数格式化问题。不需要花时间对齐结构体字段的注释。
CODE_BLOCK_155
《Effective Go》中对命名有明确的惯例,遵循这些约定能让你的代码更容易被其他 Go 程序员理解:
1. 包名(Package names)小写、单单词、简短:、、,不需要下划线或驼峰包名是导入时的默认访问前缀(如 ),所以宁短勿长包名 = 源码目录的 base name: 目录下的包名是 (不是 )避免重复: 包里的 Reader 命名成 而不用命名成 ,因为使用者使用时用的 ,不需要特别在命名上区分构造函数命名: 包只有一个公开的类型 ,构造函数命名为 (),而不是
2. Getter 和 Setter
Go 不自动支持 getter/setter,但可以自己写。Getter 方法名不要加 前缀:
3. 接口命名单方法接口:方法名 + 后缀 → 、、、多方法接口:用能描述其行为的名称 → 、如果你的类型实现了与知名接口相同语义的方法,用相同的名称和签名:字符串转换方法叫 而不是
4. 驼峰命名(MixedCaps)
Go 使用 或 (驼峰式),不使用下划线分隔单词:
CODE_BLOCK_157导出的函数/类型/常量必须有注释,且注释以声明名称开头 块注释主要用于包注释或禁用大段代码出现在顶层声明之前(中间没有空行)的注释被视为 doc comment,会被 提取
错误处理:每个 error 都必须检查,不要用 忽略 error 返回值并发安全:文档中说明类型/函数是否并发安全
从 Java 到 Go 的思维转变:#转变Java 思维Go 思维1面向对象类 + 继承结构体 + 组合2错误处理try-catchif err != nil3并发模型线程 + 锁goroutine + channel4依赖管理Maven/Gradlego mod5接口实现显式 implements隐式满足6代码风格灵活多样go fmt 统一7泛型支持成熟(Java 5+)较新(Go 1.18+)8构建速度较慢极快
建议:接受 Go 的设计哲学,不要试图用 Java 的思维写 Go 代码多读标准库代码 - 学习 Go 的惯用写法理解并发模型 - 这是 Go 的核心优势,值得深入学习==Go语言快速学习指南(2025年更新版) - 知乎==10分钟上手 Go 语言:从安装到编程实战!==官方文档====A Tour of GO==Effective GoGo Best Procticesgo语言中文网GOFRAME (文档和教程丰富)8 小时网课